2008年2月21日 星期四

與成功有約

書藉基本資料: 與成功有約(The seven habits of highly effective people : restoring the character ethic)

中文譯名有點鳥,英文的書名可能不會那麼排斥。

講大道理的書滿街都是,偶而經過書攤我會挑個一兩本翻一下目錄,若目錄裡列的道理看一眼沒能體會又有興趣的話,就翻到該段掃一遍內文,領會到背後精神後就把書合起。印象中這類書小故事一堆,廢話也多,可能不用半小時就能掌握80%有用的內容,或是不看也沒差。

《與成功有約》到是出乎意料之外,第一章我愈看愈仔細,到後來變成用讀一般書的方式來看。作者舉了許多好例子,規則也整理得很清析,打破我以前對這類人生道理書的偏見,這本書值得花多一點時間看,反而是看個幾頁,合起書來想想,去忙別的事,改天再回來翻後幾頁。

作者強調要以和別人分享書中心得的方式來讀此書,如此才能達到讀書的最大功效,我相當認同這個觀點,寫心得文除了和大家分享外,一方面也是讓自己整理思緒,確認是否真的領會到書中的觀念。俗話說得好,「唯有用自己的話說出來時,你才真的懂了」,我完全同意這個觀點,光憑作者的這項要求,就能明白作者不是普通的大道理作家,只會說些空泛的言辭,而懂得如何實踐。

還有一些有趣的例子,前面提到要由內而外全面造就自己,像是父母管教孩子,有時不是管不好孩子,而是以為為孩子好,其實是為自己的面子。當孩子成績不如意時,真的是擔心他未來前途,還是擔心和親友聊天時的負擔?唯有看清自己,才能放下自己的成見來教導孩子,也唯有這樣,孩子才會接受父母的協助,而不是認為被管教。

提到時間管理時,作者請讀者先想想,不管是個人生活還是工作方面,有那些事是認為重要,但遲遲沒有執行的事?接著,作者依重要和緊急分成四種類型的事,即:重要且緊急、重要卻不緊急、不重要但緊急、不重要也不緊急。回想一下日常生活,會發現不論重要與否,自己卻被緊急的事搞得精疲力盡。於是,剛才想到的重要卻不緊急的事,就一直都沒有執行,直到有天發現不做不行,或是做了也來不及時,才來後悔。對我來說,我高一時就明白數學和英文很重要,應該一天各花一小時學習。遺憾的是,我一直沒落實這想法,偶而落實一陣子,也感受到它的成效,卻又被其它緊急事情打破,最後不了了之。

另外像主動積極的觀念,描述的很清楚,這個想法是相當重要的第一步。關於主動積極部份,可以參考《李開復給中國學生的信:做個積極主動的你》,李開復文中的說法和本書很像,印象中李開復演講時提到的參考書藉好像有本書。可以觀察一下身邊的朋友,找出符合這想法的人,透過身教更能感受到主動積極的優點。大學前我只能算普通積極的人,後來認識skylight、會長這些人,從他們身上學了不少,漸漸地改變自己,做事的成果也確實改善許多。

總結來說,本書強調「依賴 -> 獨立 -> 互賴」的成長過程,言簡易駭。用例子來說,想要有可靠的同伴,唯有自己先成為可靠的同伴;想要別人尊重自己,唯有自己先尊重別人。類似的例子俯拾皆是,配合親身經歷後,感受更深。

2008年2月16日 星期六

研究科學的第一步 - 初步心得

書藉基本資料: 研究科學的第一步-給年輕探索的建議

有趣的是,一開始作者提到,天才不用人教,我們只能教一般人,而且做研究的方法千百種,每個人自成一格推論方式,除了大家都懂的大原則外,學一堆方法沒有用。那麼,寫這種教人家做研究的書有啥用?作者在搬石頭砸自腳後,說明教理論方法是沒用的,但勸告是有用的。導讀裡也提到這本書的重點在培養各種個性(如耐性),而非研究理論。網路上也可找不到不少大師分享培養個性的文章,不知是否時機成熟,現在看這本感覺特別受用

這本書意外的好讀,沒太多障礙就讀了不少內容,收獲不少。目前剛看完第二章提到坑殺新手的陷阱,對我來說意外的受用,剛好自己進行研究一段時間後才來看,感受更深;第三章提到需要何種心智能力也是鞭辟入裡。作者強調做研究只需要平凡的智能,加上培養好個性即可,書裡有詳細的說明,作者的諸多譬喻相當生動易懂,值得一看。像說明專注時,作者以長期曝光拍攝原本看不見的星星為例,說明專注帶來的效果。原本想寫些什麼心得,可是重點太多了,寫起來又很像一般廢話,大家還是自己看書吧。

Java Puzzlers

書藉基本資料: Java Puzzler中文版-陷阱、錯誤與死角

和《Effective Java》類似,這本在講Java的特性。不同的是,這本著重在以易犯的錯誤例子來說明正確的準則,而《Effective Java》是直述守則。本書在說明錯誤時,常引用別處文獻說明進一步資訊上那找,其中大部份的參考文獻出自《Effective Java》。另外不同的一點,本書的述說語氣比較風趣,偶而還有有趣的爛解答。哦,還有附一堆相當傷眼的錯覺圖,我時常用手遮住它們,以方便我能舒服地閱讀文字。然而兩本相較之一下,《Effective Java》較值得看。

不過相較於《Effective Java》直接說怎麼做較好,這本書到是相當成功地說服讀者,為什麼不要那麼做,例子舉得相當漂亮,帶來不少衝擊。本書不宜長時間連續閱讀,讀起來相當傷腦,一堆看似正常的程式碼,卻常發生不可思議的結果,或是不知所云的編譯錯誤訊息。或許,當Java寫到一定程度時,看這本書可以協助除錯。以下簡單直述部份心得,若對解謎有興趣的話,就別看下面的心得,自己慢慢翻書也是種樂趣。

  1. final對於method和field的含意不同,field的final是指只能設值一次,所以
    final int a;
    a = 3;

    是合法的。但也因這個特性,會有些潛在問題,例如:物件因為初始化順序不同,而讀到未初始化的final field。解法:lazy initialization。

  2. 除非之前有執行 System.exit(),finally一定會被執行到,這意味著在finally之前的return和throws exception會被finally給蓋過!。
  3. constructor內不要呼叫被覆寫的method,有可能因物件初始順序而讀到未初始化的欄位。可用lazy initialization解決。
  4. 一些計算機組織的知識,像是 IEEE 754對浮點數的定義,使得太小的小數無法加進去,例如:

    float a = 2.0E20f;
    a += 1.0; // 結果仍是2.0E20f

    還有因為負數用二補數表示,負的MIN_VALUE不存在對應的正數,abs(MIN_VALUE)結果仍是負的MIN_VALUE。

  5. 要分清楚overriding、overloading、hiding、shadowing、obscuring。Java 5.0後,override時記得加 @override 避免 method 寫錯宣告時變成 overloading。還有別用參數數同一樣且有父子關係的 overloading,例如下面是個不好的 overloading,由於 JVM 會找最接近型態的,而可能呼叫到非你想要的:

    public boolean equals(Object o) {return true; }
    public boolean equals(String o) {return true; }

  6. method的覆寫 (override)不能變得更限制(例如public不能變protected),但field可以,此時稱為 hiding(亦有其它情況會發生 hiding),例如下面的例子是合法的:

    class A { public static String s = “A”; }
    class B extends A { private static String s = “B”; }
    A o = new B();
    System.out.println(o.s); // 結果為:A

  7. 用class method時,使用class名稱呼叫,避免呼叫錯誤。注意:((Math)null).PI 是合法的,JVM不會理會object,而會直接找它的class。
  8. Java 5.0支援泛型後,盡量不要使用原始類型(例如 List),那是向下相容的必要之惡;改使用參數化類型(例如 List<T>)。千萬不要混用原始類型和參數化類型,#88會給你滿意的理由,為何不要這麼做。
  9. 不要在一個運算式裡改變一個變數多次,這牽涉到實作細節,比方 x^=y^=x^=y 這個有名的例子,在 Java 裡不會成功的 swap。
  10. 不要在一個運算式裡將型態自動向上向下轉型(例如 int 變 long或反過來),這之間有很多潛在問題,詳情參閱前面的puzzles。
  11. char是無號型態,其它byte、int等都是有號的;16進位沒有正負號,它直接以二補數解讀;< <、>>等只看最低的5 bits數,a < < 31和a << 63意思一樣(小心負數的情況)。

2008年2月11日 星期一

重看心靈補手有感

剛才重看一次《心靈補手》,忽然有些感觸,特別是主角在賣弄完他的聰明才智後,卻回答不出一句”What do you want”;還有MIT教授和心理醫生兩位老友吵架那段,提到自己認定的成功,被別人「可憐」的失敗;還有主角的好友說他已獲得了百萬元獎卷,卻窩囊的不敢兌現。想到我小時候嚮往的學院生活,想到自己的缺點。對於自己適合做什麼,將來想做什麼,似乎又更明確了些,剩下的就是實踐計畫,再看看是否真的如此吧。

現階段我唯一確定的是,我不如自己想像般地了解自己想做什麼。先能承認自己的缺失,才有改正的可能。我明白我老是想太多,太害怕而不敢踏大步一點。想要的太多,卻沒耐性一步步執行,或著是不明白自己最想要的為何。比較可取之處,則是跌倒了爬得起來,而且敢再嘗試。接下來我得先學會的,是慎重緊密的思考後,從容地放下,一鼓做氣大膽地執行到底。首先,我得再多花點時間,繞個小圈,來看看我想做什麼。

勇闖資訊新未來:打造資訊科技的幕後英雄

書藉基本資料: 勇闖資訊新未來:打造資訊科技的幕後英雄 (Out of their minds : the lives and discoveries of 15 great computer scientists)

前幾個月對於是否要讀博班、是否要從事研究工作感到困惑,就找了這本書來看,看看大師們怎麼說。中譯名稱不太好,這本書收錄了15位Computer Science 界大師的傳記,並穿插和大師們的訪談。從軟體到硬體;從計算機結構、演算法到人工智慧,包含諸多CS子領域。最後的後記分析大師們成功原因的異同。這本書的中譯相當不順,如果可以的話,或許讀原文較好。

總結來說,大師們相似部份很少,令我驚呀的是,包含發明BNF的John Backus在內,有幾位大師是年輕時不知做什麼好,先去當個幾年兵回來,才找到人生方向。遺憾的是,究竟是什麼讓他們找到目標,書裡沒有進一步的說明,似乎男人當個兵回來就能發現方向。仔細地分析,演算法、學術型的大師,大多是學生時代就表現過人,可能不是在CS領域發光發熱,總之就是優於一般水平的學生。至於對研究的看法,看法差異很大,Dijkstra說找最難的做;提出planar graph快速解法、network maximum flow的Robert E. Tarjan說要挑對問題,從實際應用面下手;然而對分散性系統有深入研究的Leslie Lamport(提出bakery algorithm)說要找有興趣的問題,他甚至這麼說:

我也很懷疑別人會因為某項問題非常重要,覺得此項研究非常有趣。好的研究來自於你認為某項研究是有趣的,然後想要好好和它玩一玩。

其它像讀到Fred Brooks的故事滿高興的,我很喜歡他寫的《人月神話》,這本大概是我做筆記最認真的一本書。還有Douglas Lenat提的Automated Mathematician和Cyc也很有趣。沒有絕對的正確,我們有許多認知相互衝突,現實世界不如數學,能用一個完美式子推衍含蓋,人工智慧的研究也該接受現實的亂象,才有可能實現。人類在判斷時會依自己的認知,潛意識地在不同的前提做出正確的判斷,比方書中提的例子,「德古拉是誰?我們會回答「吸血鬼」;世上有吸血鬼嗎?我們會回答「沒有」。即使上述兩個問句和答案,邏輯上令機器感到困惑,卻不會造成我們任何困擾,因為問答時的背景不同。

若對研究感到一些疑問,讀這本書只會得到更分歧的答案。不過就像讀個案研究一般,讀到一個程度後,會對於整個時代背景有些感覺,而明白一件事,我所處的時代和他們不同,他們的故事無法給我明確的指引,我得自己走一遍,才知道自己的路在那。之前問一些教授他們當時要出國讀博士,才發現他們的環境和現在不同,所以老教授們的回答差不多:他們是不得不出國。現在學校的選擇變多,工作的可能性也變雜,使自己過於煩惱要怎麼選。經過這些談話,以及讀過這本書後,我體驗到時代背景差異的重要性,事前準備已夠了,我得多花點時間在自己的嘗試上。

2008年1月27日 星期日

用automata的path做為memory

最近想整理一下過去修課時散落的心得,就這樣隨時間過去而忘記挺可惜的。

在讀 DFA/NFA 時就有這種感覺,利用 state 的連結方式或某種 path 的展開,可以表示特定記憶狀態,比方若 language 的 size 為有限個,可以把每個 string 以一個 state sequence 表示,於是這些 state sequences 的聯集會成為 state tree,藉此記下整個 language。

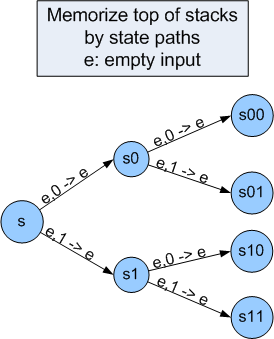
這概念運用到 PDA 更有效果,如果想記住 stack 最上層有限個元素,可以在PDA裡加入由2^k個state表示的 tree,記下 stack 裡 top k 元素,像下圖所示:

由 state s 連出的上面那條 path 表示 stack 最上面的元素是 0,下面則表示 1。即使被 pop 掉了,由此延伸,就能同時「多看」幾個 stack 內的元素,比方比較 stack 最上面 3 個和 最下面 3 個是否一樣。由於 PDA 的 state 數是有限個,所以這個做法無法記下無限長的 input string,並且,在建立 state 時就要設計好要記憶多長的內容,比方我們假設最多記 k 個 input,萬一輸入多了一個,這個做法就失效了。所以,在記憶的功能上,這個做法同樣地比不上 Turing Machine,這是先天架構的限制。

以實例來看,FA 和 PDA 都可以判斷部份 ww 類型的字串,只要事先建好長度為 1 ~ k 的 ”state path”,配合 Non-deterministic 的做法 [1],即可判斷。但我們無法處理任意長度的 w,當 |w| > k時,就無法處理了。

由此想法發展, 我想到 Neural network (NN) 用 node、link、link weight 表示memory,類似的概念在 NN 裡已被提過:linking structure 表示 memory,training 就是將資料記到 linking structure 裡,所以 training 的同時也會破壞 memory。

這個想法很有趣,也能類推到人腦運作,不過不管從正反面來看都有用也有問題。可以說新 input 會造成舊的 knowledge (memory) 被破壞,但也不知道是那個 knowledge 被破壞,也可能是重組成新的 knowledge,隱含可以推論出包含舊有功能和新功能的 knowledge。唯一可以確定的是,link structure 的大小決定了記憶容量。在 FA 和 NN 之間,應該還有更深入的關聯性可以思考,或許可以有系統地分析 NN,從而改進 NN 的不足。

ps

做法:

  1. 假設 |w| = i,讀入 i 個 input,並將其「記在」state 裡,舉例來說,s1001表示先前讀到的順序為 1、0、0、1。
  2. 往後讀 i 個 input,若讀入的順序和先前「記住」的順序相同,且讀完 i 個 input 後剛好到字串結尾,Accept。

配合 Non-deterministic 的特性,從起點開始會有 k 條叉路,只要有一條猜對|w|,就能正確判斷。

2008年1月25日 星期五

減少操作實驗浪費的時間

分享一下之前做實驗時發展出的小技巧,我這裡指的是跑程式的實驗。花點時間研究一些工具,可以剩下不少重覆執行的動作。

首先,畫圖方面 gnuplot 是最好的選擇,用法很簡單,google一下學個基本,之後要用什麼特殊指令,去 Demos and Screenshots 裡找符合的圖,將範例code抓下來試一試,改一改就會用了。看到常用的指令或參數,就到 Documents 的 Index 裡找詳細說明(比方查 xrange 的用法),減少試誤的時間。

gnuplot 最大的好處在於批次處理,初期費些工夫寫出滿意格式的 gnuplot code,接著就可以把所有圖表套用一樣的格式,想變更格式時,比方加格線或放大字型,只要改一份 code,所有圖表可以一同更新,這是 Excel 難以做到的,也許 VBScript可以,但學習代價應該會比 gnuplot 高。若會寫 shell script或scripting language如Perl、Python、Ruby、PHP,可以配合script和寫好的gnuplot code,執行一個程式讀入不同的資料檔,即可重畫所有圖表,這點 Excel 更不方便達成。配合 script 還可以自動轉成 LaTeX 用的圖檔格式。若不滿意 gnuplot 預設 EPS 的風格,像我較喜歡預設 PNG 的話,可以配合圖檔轉檔軟體,可以輕易地批次處理,像 Linux、FreeBSD上可以用 convert。做實驗時常要重畫圖表,很少能一次搞定,初期投資些時間在 gnuplot 和批次處理程式上,絕對會回本的。

若想再進一步自動化的話,可以將實驗結果存到資料庫裡,不要存到普通檔案裡。花點時間研究如何用 scripting language 或自己慣用的程式語言操作DBMS(如MySQL),看要在實驗結束時程式直接將結果寫入資料庫,或是先寫入暫存檔再另用別的語言 (例如直接用 MySQL script)將結果寫入資料庫。於是,透過 DBMS 網頁介面的軟體(如phpMyAdmin),可以輕易地觀察實驗結果,像是依時間排序資料、依數據大小排序,或要算平均、標準差等,都輕而易舉;要輸出成 gnuplot 或其它程式的輸入格式,也是非常容易。

最後,跑實驗的程式最好寫成從命令列讀參數,或讀一個設定檔設定參數,減少重新編譯的動作,也方便批次實驗不同參數。

總結一下,我自己的做法是:

  1. 實驗用的程式從命令列讀參數。
  2. 其中一個參數決定要將實驗結果直接輸出(STDOUT) 或寫入 MySQL。有時候做些小更動想看看實驗有什麼差別,不想塞太多資料進資料庫弄亂原有資料,可以下參數讓程式不要寫入資料庫。
  3. 用 shell script 寫好測試用的批次檔,會輸入不同參數給實驗用的程式,產生所有要的結果。
  4. 裝 phpMyAdmin,方便分析實驗情形,以及輸出 gnuplot 要求的輸入格式(用TAB分隔)。
  5. 寫好 gnuplot 的 code,我不知道怎麼在 gnuplot 裡使用變數,讓它能配合shell script對畫圖作細部調整(如更改輸出檔檔名),所以我改用笨一點的做法,將gnuplot code存成字串,用Ruby配合不同變數產生有點不同的 gnuplot code 到文字檔裡,再執行 gnuplot 讀入新產生的 code 以符合細部調整。
  6. 寫個簡單網頁顯示 gnuplot 輸出的 PNG 檔,方便用圖形觀察各組數據的差異。再寫個 script 利用 convert 把所有 PNG 檔轉成 EPS,確保論文裡的圖檔和我想要的樣子一致,但會犠牲向量圖檔任意放大的優點。

上述的方式我試過幾次,幫我省下不少時間,第一次試用時間投資就有回本,更不用說第二次之後的收益了。舉例來說,我其中一個實驗要求是記錄演算法各段落執行的時間,想配合各種不同資料量,判斷演算法的子項目平均時間差多少。但用 profiler 會拖慢執行速度,我只想記錄幾個主要步驟而已。這時輸入到 MySQL 變得相當順手,執行一次批次檔,上床睡覺,隔天早上下個 SQL 做平均,就可以看出差異。找出關鍵的部份後,再下 SQL 選出關鍵資料的細項,看看資料分佈的情況,有助於了解情況。想想看,若不用自動化實驗和資料庫來呈現數據,前述動作有多麼冗長無味,你會想重覆幾次這樣的事?更不用說集中精神分析結果和思考改進方式了。